双RTX 4090本地部署 Qwen、Qwen-Image 与 MiniMax H3:档案编研技术验证
以双RTX 4090工作站为例,验证Qwen文本处理、Qwen-Image制图和MiniMax H3视频生成在档案编研中的分工、显存调度与结果检查。
双RTX 4090本地部署 Qwen、Qwen-Image 与 MiniMax H3:档案编研技术验证
以双RTX 4090工作站为例,验证Qwen文本处理、Qwen-Image制图和MiniMax H3视频生成在档案编研中的分工、显存调度与结果检查。
文章属于行业研究与技术科普,不替代项目设计、合规审查或招投标技术文件;引用时应保留来源、标题和原文地址。
档案编研把语言、图像和视频模型放在一条链路上。模型能否启动只是第一关,更容易出错的是输入和输出没有分清:未经核对的OCR被当成事实,生成插画被当成历史照片,视频模型的补全被当成档案记载。
下面按一台Linux工作站、两张RTX 4090、每张24GB显存来做部署验证。Qwen3-8B负责文字整理和脚本初稿,Qwen-Image负责说明性插画或视频首帧,MiniMax H3负责少量示意镜头。三者串行运行,不默认并发,也不把两张卡当成一块自动合并的48GB显卡。这组配置只作为可复现的起点,双4090的速度、显存峰值和成片效果仍需在目标机器上测量。
实际编研时,模型边界可以先用下面这张表固定下来:
| 输入 | 模型 | 输出 | 必须人工确认的内容 |
|---|---|---|---|
| 已完成OCR校对的文字、档号、页码 | Qwen3-8B | 证据摘录、未决问题、解说词初稿 | 引文是否支持结论,日期和因果关系是否被改写 |
| 已审定的脚本、原件照片或构图要求 | Qwen-Image | 说明性插画、视频首帧 | 画面是否会被误认为原件,生成细节是否超出材料 |
| 已审定首帧、动作描述、镜头时长 | MiniMax H3 | 短视频镜头 | 建筑、人物、文字和设备是否发生错误变形 |
原件仍然是主体,模型主要处理材料之间的解释、排版和镜头衔接。这个顺序会直接影响返工量:事实改动只重跑受影响的脚本和镜头,配色或运镜改动则不必重新处理档案摘录。
先处理证据,再生成内容
假设编辑拿到的材料里,批复写着某年3月同意迁建,生产记录写着7月开始试生产,厂史照片背面的说明写着“9月新厂落成”。这几份材料都是教学用的虚构材料,不对应具体馆藏。
如果直接让语言模型写“工厂于某年迁入新址并正式投产”,它很容易把三件事压成一件事。句子很顺,具体意思却变了:批准迁建、试生产、落成,分别对应行政决定、生产活动和工程节点;正式投产是否发生在同一年,还需要其他材料。
处理顺序应该固定为“材料筛选、OCR校对、证据摘录、编辑采用、脚本生成”。Qwen只接收已经通过前两步的材料,并把每份材料分别摘录,保留档号和页码,另列相互矛盾的日期。编辑先决定专题要讲什么,再把采用的事实交给模型改成解说词。选题和事实取舍不能交给模型参数决定。
输入也不必一开始就是整个全宗。编研人员可以先选出相关文件,按事件或人物切成小批次;专题确实涉及大量分散材料时,再加入本地检索。检索接口返回的每条材料都要带权限结果、档号和页码,权限过滤必须在模型调用之前完成。模型只处理允许进入本次任务的文本,不能让它从十万条记录里自己“判断哪些可以看”。
一次整理结果可以保存为下面的结构。日期和引文是虚构示例,正式使用时必须替换为实际档号、页码和核对后的文字:
{
  "event": "工厂迁建",
  "sources": [
    {"id": "DEMO-01", "page": 2, "quote": "三月同意迁建", "meaning": "批准"},
    {"id": "DEMO-02", "page": 8, "quote": "七月开始试生产", "meaning": "试生产"},
    {"id": "DEMO-03", "page": 1, "quote": "九月新厂落成", "meaning": "照片附注"}
  ],
  "unresolved": ["正式投产日期尚无直接材料"],
  "editor_approved_sentence": "迁建获批后,新厂于当年七月开始试生产。"
}
最容易漏掉的是“引用存在”与“引用支持结论”之间的差别。软件可以检查档号、页码和摘录是否存在,却不能仅凭这些字段证明一句话成立。手写数字模糊、原件缺页或不同文件互相矛盾时,记录未决状态,不能用模型补齐。
事实表通过后,Qwen再做改写:把“经研究同意”改成“迁建方案获批”,按朗读节奏拆句,删除不影响事实的书面套话。原文没有说明迁建原因,解说里就不能补“为了扩大生产”。模型可以提供段落顺序,但因果关系仍由编辑逐句确认。
Qwen3-8B先做基线,不急着上大模型
这台机器先部署开源的Qwen/Qwen3-8B。它承担的是文字摘录、事实表转写、段落改写和镜头说明,不承担扫描件识读。需要看图时,应使用支持图像输入的Qwen-VL模型,并把图像识读结果单独留痕。
8B模型的价值在于建立基线:同一组材料重复运行,检查日期是否漂移、未决问题是否被保留、跨文件摘录是否漏项。只有确认输入没有OCR错字、缺页和上下文截断,再判断是否需要14B或更大模型。显存加大不能修复错误的输入。
Qwen3-8B的BF16权重按参数量粗算约16GB,实际运行还要装下KV缓存、计算临时空间和框架开销。单张24GB卡适合从短上下文、单请求开始,不能仅凭权重大小承诺能跑多长的材料。下面是在依赖和模型文件已准备好的Linux机器上的服务启动示例,路径需要换成自己的模型目录:
HF_HUB_OFFLINE=1 TRANSFORMERS_OFFLINE=1 CUDA_VISIBLE_DEVICES=0 \
vllm serve /srv/models/Qwen3-8B \
  --served-model-name archive-editor \
  --host 127.0.0.1 --port 8000 \
  --dtype bfloat16 \
  --max-model-len 4096 \
  --max-num-seqs 1 \
  --gpu-memory-utilization 0.85
这里把总上下文限制为4096个token,输入和输出共同占用这个额度;长文件先分段,留出生成答案的空间。它是节制显存的起步配置,读者仍需在自己的驱动、CUDA、vLLM组合下检查能否加载。模型、分词器和依赖应在联网准备区下载并核验,再转入离线环境;两个离线环境变量也不能代替网络隔离。
整理摘录时,可以关闭Qwen3的思考模式,减少不需要的推演文字。兼容的vLLM接口支持在请求中传chat_template_kwargs,将enable_thinking设为false。参数先固定在模型卡给出的非思考基线:温度0.7、top_p=0.8、top_k=20。然后用同一批材料比较更低温度是否减少改写漂移,再决定是否调整采样参数。温度降低不等于事实正确;逐字摘录仍应由程序比对原文,并由编辑确认上下文。
Qwen-Image只生成说明画面
图像部分选用开源的Qwen/Qwen-Image。模型文件、调用示例和参数都按这个具体版本准备,换用其他版本时重新检查依赖与显存需求。
工厂迁建专题只有新旧厂房照片,没有搬运现场时,不应直接生成“工人搬设备”的写实场景。设备型号、运输方式、劳动防护和厂门朝向都会被画面具体化,观众很难分辨这些细节来自档案还是模型补全。
更稳妥的做法是生成一张说明图:用两个抽象厂区表示空间变化,用路径表示迁移关系,明确采用插画风格,不放具体人物、设备、年代标志或地名。标题、日期、出处和数字交给排版软件添加,图像模型不处理需要准确识读的文字。照片修复、缺损补绘也要单独记录,补出的细节没有史料依据。
Qwen-Image适合生成这类说明性插画、专题视觉背景和经编辑确认的分镜首帧。如果要对现有图片进行受控编辑,应另选相应的Qwen-Image-Edit权重及配套流程,不能把文生图模型的名字填进编辑接口就算接好了。照片去污、色调调整、缺损补绘也应区分记录:补绘出来的细节没有因此获得史料依据。
双4090并不意味着原始Qwen-Image可以轻松全量常驻。它的图像生成主干约20B参数,BF16主干权重粗算约40GB,尚未包括文本编码器、VAE和运行中间量。两张4090没有NVLink,显存不会自动合并。即便显式切分主干,整条管线的峰值也可能超出可用空间。
试做时有两种现实选择:使用来源、许可证和运行后端都明确的兼容量化版本;或者保留原始权重,通过CPU卸载减少显存占用,接受更长等待。后一种方法建议准备至少128GB系统内存作为规划起点,有条件再留到256GB,并以实际加载峰值决定是否足够。模型缓存和输出还会占用磁盘,不能只预留权重文件的空间。
下面是原始权重逐层卸载的示例。运行环境需包含支持Qwen-Image的Diffusers、Accelerate和匹配的PyTorch,且本地目录已包含完整模型组件。它用于说明显存受限时的调用方式,没有经过本文所设双4090机器的运行验证。
import torch
from diffusers import DiffusionPipeline

pipe = DiffusionPipeline.from_pretrained(
    "/srv/models/Qwen-Image",
    torch_dtype=torch.bfloat16,
    local_files_only=True,
)
pipe.enable_sequential_cpu_offload()

image = pipe(
    prompt="专题说明插画,两个简化厂区以路径相连,平面几何风格,无文字,无具体地标",
    negative_prompt=" ",
    width=1024,
    height=576,
    num_inference_steps=50,
    true_cfg_scale=4.0,
    generator=torch.Generator(device="cpu").manual_seed(42),
).images[0]
image.save("factory-move-illustration.png")可以用CUDA_VISIBLE_DEVICES=1启动这段脚本,让它只看到第二张卡;进程内这张卡会重新编号为cuda:0。开启逐层卸载后,不再调用pipe.to("cuda")把整个管线搬回显卡。与只搬移整块模型的卸载方式相比,逐层卸载通常更省显存,也通常更慢,适合先验证功能,不能据此承诺批量生产速度。
50步、引导强度4.0来自该基线模型卡,1024×576是这里选择的预览尺寸。降低步数时,要用同一画面观察结构是否明显变差;换成蒸馏权重或加速LoRA后,则按那套配方重设步数和引导强度。把所有模型都统一成“10步”,很容易把某个加速模型的经验错套到另一个模型上。
一分钟专题里,H3可能只需要生成两小段
编研短片可以先用原件、解说和简单剪辑排出一版。这个虚构专题的一分钟,可以这样分配画面:
| 段落 | 展示内容 | 处理方法 |
|---|---|---|
| 约15秒 | 迁建批复和关键原文 | 原件局部放大,后期加标注 |
| 约15秒 | 新旧厂区照片与时间关系 | 原照片剪辑,日期后期排版 |
| 约10秒 | 生产空间转移的说明 | 示意图或两个短生成镜头 |
| 约15秒 | 试生产记录及其含义 | 原件展示,解说保留措辞差别 |
| 约5秒 | 出处与制作说明 | 常规片尾排版 |
时间只是剪辑草案。原文太密,就延长展示;解说尚未说完,就删掉装饰画面。为了塞进一分钟而删掉“试”字,比少一个漂亮镜头严重得多。
H3的输入应当是已经选定的示意首帧、动作描述和镜头时长。档案编研镜头可以只安排一个变化,例如镜头缓慢推进,画面结束在下一段原件能够接入的位置。先检查建筑、道路、设备和文字是否变形,再评价运镜效果。
如果原照片只需要平移、缩放、局部高亮,用常规剪辑即可。把老照片交给视频模型后,窗户可能移动,人物可能换脸,招牌可能变字;观众未必看得出这些变化。确实采用生成镜头时,应在出现该镜头时标明“AI生成示意”,不只在片尾放一行说明。史料没有支持的具体人物行动,也不要通过逼真的表演偷偷补进去。
H3本地权重与ComfyUI的工作流需要配套。当前官方文档分别提供文生视频、首尾帧、参考生成等模板;选图生视频模式就使用对应权重,不能拿首帧模板去承诺多参考控制。主干、文本编码器、视频VAE和音频VAE也要成套准备,缺了其中一项,只有主模型文件仍然跑不起来。
原生模板的横屏参考尺寸是1344×768,宽高按32的倍数设置。显存紧张时,可以先试低分辨率、四五秒的单镜头,但这属于降规格试跑,需要另看结构和细节损失;不能拿中转站接口里一个“480p”选项直接当成本地节点参数。24帧每秒的模板还会把帧数对齐到17k+5,所以请求的秒数与最终时长可能略有差别。
采样也有具体区别:官方首尾帧模板普通模式以20步起步,启用配套Turbo LoRA后才使用8步;参考生成模板的Turbo则有4步配方。对需要保持参考细节的镜头,可以比较普通模式20至25步的结果。降低步数时把主干、LoRA和模式一起核对,不能只改一个数字。
H3还需要配套的文本编码器,把画面描述转换成视频模型使用的条件。它和整理档案、写解说词的Qwen3-8B不是同一个组件。Qwen3-8B服务已经启动,不代表H3的编码器已经准备好;聊天模型也不能直接替代视频工作流中的编码器。
同一镜头固定首帧、随机种子和描述,每次只变一项。画面主体发生改变,优先检查首帧与动作要求是否冲突;轻微运镜却生成复杂行动,就减少动作描述。增加分辨率通常修不好错误的建筑结构,增加步数也不能把编造出来的历史细节变成事实。
声音同样需要编辑。H3可以输出声音,但专题旁白宜用已经审定的文稿单独录制或合成,再与画面剪辑。为一张历史照片生成机器轰鸣,不代表当时就是这种声响;需要时标成后期音效。让模型替历史人物说出档案中没有的对白,更不适合直接混进纪实解说。
双4090按阶段调度,不做假并行
两张卡应按阶段调度。先批量整理文字、审定脚本,再制作图片,最后生成少量视频。所有模型长期驻留只会增加显存冲突和排错成本。
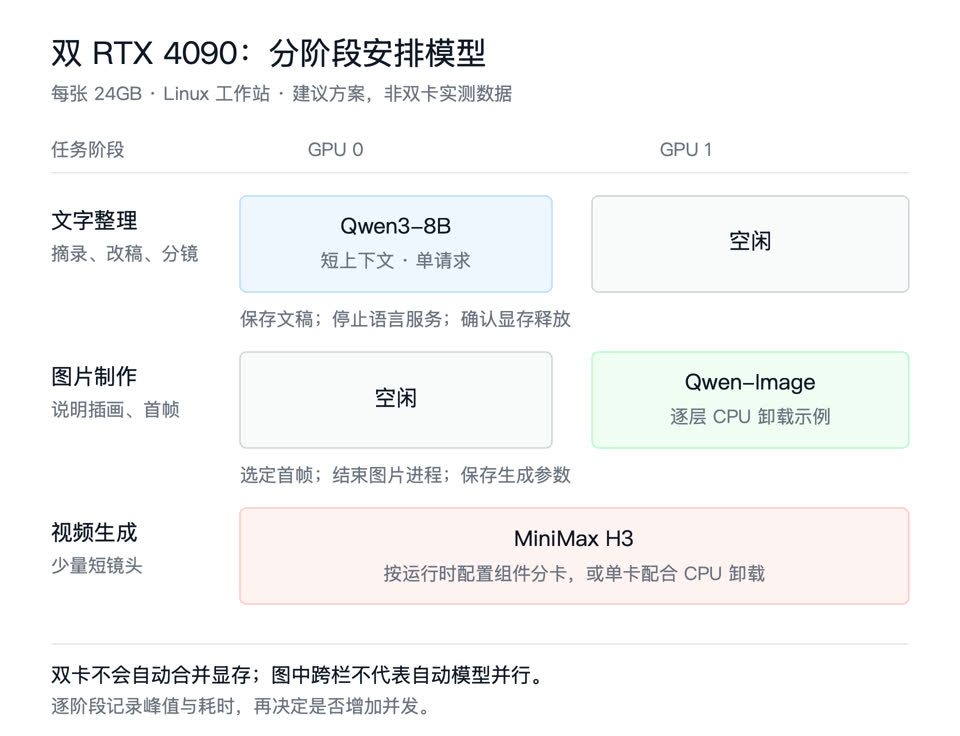
文字阶段,卡0运行Qwen3-8B,卡1空闲。文稿通过后,把摘录、采用的事实和镜头表保存到项目中,停止语言模型服务,确认进程退出、显存释放,再进入图片阶段。仅仅在Python里调用一次清缓存,无法释放另一个进程仍在持有的显存。
图片阶段可以让卡1配合CPU卸载运行Qwen-Image,先一张一张地出候选。选定首帧后保存该图、模型版本、随机种子和生成参数,结束图片进程。视频阶段再把空出的显卡资源交给H3:运行时支持组件分卡的,显式设置分配;只支持单卡的,就按它支持的卸载策略运行。设置CUDA_VISIBLE_DEVICES=0,1只能让程序看见两张卡,不能自动获得模型并行,也不能保证速度翻倍。
串行调度更容易定位显存溢出发生在哪个阶段,也不会让图像模型和视频模型互相抢资源。只有单任务的峰值显存、耗时和主机内存都有记录后,才值得尝试语言模型与图片生成并发。双卡同时负载还涉及机箱空间、散热和电源,3090机器上的功率限制与温控值不能直接套到4090上。
部署验证至少要记录下面这些数据,不能只记“能不能跑起来”:
| 阶段 | 记录项 | 通过条件 |
|---|---|---|
| Qwen3-8B | 首次加载时间、峰值显存、单请求延迟、重复运行差异 | 服务在离线模式启动,日期和引用不随重复运行漂移 |
| Qwen-Image | 模型加载时间、峰值显存、主机内存、单图耗时 | 生成尺寸固定,输出文件完整,未发生隐式联网 |
| H3 | 编码器和视频VAE是否加载、采样步数、视频时长、显存峰值 | 首帧主体可辨,视频帧数符合工作流设置,结果可回放 |
每次只改一个参数。比如先固定模型、提示词、尺寸和随机种子,只比较步数;再固定步数,只比较分辨率。这样才能知道画面变差究竟是采样不足、显存卸载,还是输入描述发生了变化。
本地运行也要检查软件配置。素材不得在失败重试时自动切到云端,插件不应擅自上传原件,模型加载后还要确认没有外部服务承担中间步骤。对受限材料,模型入口、临时目录和生成结果都应按同一项目权限管理;一张看起来已经“改头换面”的生成图,仍可能泄露原材料中的布局或内容。
软件记录依赖关系,编辑保留认定权
领至科技自研创作软件已有H3本地调用,以及镜头素材与任务结果的关联。Qwen文本处理、Qwen-Image制图和这条链路的联动,需要按编研人员的实际操作继续接入,不能把“模型已经装好”写成“业务流程已经完成”。
软件侧至少要保存三类关联:引用材料、编辑采用的表述、生成镜头。比如编辑把“正式投产”改回“试生产”,系统应找到受影响的解说和字幕,提示重新检查;只调整旁白标点时,不应重跑视频;更换首帧或动作描述时,才重新提交对应的视频任务。返工范围由内容依赖关系决定,不按整片一键重做。
生成任务还应记录模型版本、权重目录、输入摘要、随机种子、尺寸、采样步数、显存峰值、输出文件哈希和人工审核结果。只保存一段提示词,无法解释同一镜头为什么前后不一致,也无法复现一次已经采用的结果。
试做成本可以按一次小专题记账:材料核对、改稿、图片候选、视频生成、剪辑审片分别计时,再单独记录模型加载、GPU运行和主机内存占用。一个短片只留下十秒生成内容,却为了追求“历史现场感”重做几十条,通常先要调整画面方案和验收标准,不一定要换更大的显卡。
档案编研很珍贵的一点,是允许材料保留它原来的不完整。我们可以在解说中讲清知道什么、暂时不知道什么,也可以用简洁示意帮助读者理解。Qwen、Qwen-Image和H3让这些表达多了几种做法;一份好的作品,仍然要让观众分得清亲眼看到的档案,与编辑据此作出的解释。
资料与部署依据:Qwen官方的Qwen3-8B、Qwen-Image模型卡,以及ComfyUI的MiniMax H3指南。H3为开放权重,开放权重不等于无条件商业使用;当前指南要求本地生成结果的商业使用取得相应许可,项目采购时应按实际用途核对授权条款。
点击文末“阅读原文”,查看官网上的图文与代码示例。