模型贵不贵,和敏感片段该不该先被过滤,是两道题
一场错位争论背后,是模型能力、算力成本与数据权限被混成了同一个问题。把 RAG 链路拆开,才能判断敏感内容究竟有没有越过授权边界。
模型贵不贵,和敏感片段该不该先被过滤,是两道题
一场错位争论背后,是模型能力、算力成本与数据权限被混成了同一个问题。把 RAG 链路拆开,才能判断敏感内容究竟有没有越过授权边界。
文章属于行业研究与技术科普,不替代项目设计、合规审查或招投标技术文件;引用时应保留来源、标题和原文地址。
前几天,我们发了一篇讨论 AI 检索权限的文章。文章问的是一个很具体的问题:用户最终没有在页面上看到敏感片段,能不能据此证明这段内容从未进入召回结果、重排模型、共享缓存和大模型上下文?
留言区里出现了另一场讨论。有人连续从模型价格、算力投入和使用价值谈起,认为增加这些控制会推高成本,甚至据此反问:照这样的逻辑,大模型是不是干脆不要用了?对话后来又转向“是否允许质疑”。
这段交流值得写下来,目的不在追着某条留言争胜负。昵称、地区和原话都没有必要公开。需要辨析的是:双方谈的根本不是同一道题。原文讨论数据在系统内部有没有越过授权边界,留言主要讨论模型是否昂贵、使用是否划算。后者当然可以讨论,却无法直接推翻前者。
技术讨论可以反对,但应先反对文章真正提出的命题。
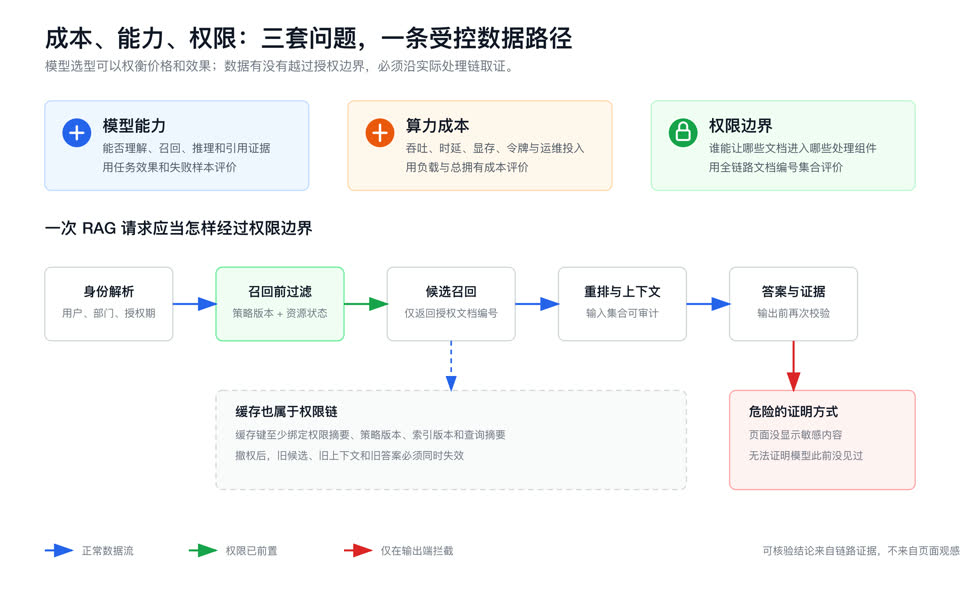
先把三件事分开
先说模型本身能不能把事情做好。同一批档案交给模型,它能不能认出“本单位”和“我单位”说的是同一个机构,能不能从几十页材料里找到关键的一段,能不能把答案指回准确页码,证据不够时会不会老老实实说“查不到”。这些才是模型效果。判断它,不能只看一张演示截图,要拿一批真实问题、错误答案和人工复核结果来对照。
再说要花多少钱。一次回答等多久,同时能接待多少人,需要多大的显存和服务器,模型运行每天消耗多少 token,后面还要不要专人维护,这些才是成本。参数量大的模型不一定适合每个单位,参数量小的模型配合更准确的检索,反而可能更省。这个问题得靠压测和账单来回答,不能看着模型名字猜。
最后是权限:谁可以看哪份材料,什么时间可以看,材料状态变化后还可不可以看。这里还要继续追问,片段能不能交给检索器、排序器和模型,答案能不能写进所有人共用的缓存。模型聪不聪明解决不了这件事,得由业务规则和安全设计来决定。
这三件事会互相影响,但谁也不能替谁解决问题。换一台便宜的服务器,不能修好权限漏洞;换一个更聪明的模型,也不会让无权访问变成有权访问;把过滤提前做好,通常只增加一段工程工作,并不等于系统从此不考虑成本。
用“模型太贵”来回答“无权片段能否进入模型上下文”,类似于讨论保险柜的采购价格时,顺便宣布门锁可以不装。价格值得核算,门锁仍有自己的安全要求。
RAG、微调和训练,到底差在哪
留言里还提到了模型调用和训练。这里确实需要讲得更白一点:RAG 调模型、微调模型、继续训练模型,根本不是一回事,花钱的地方和最后得到的效果也不同。
先拿大家熟悉的开卷考试来比喻。RAG 就像学生带着一本已经整理好的资料来答题:先根据问题找到相关页,再把问题和这几页内容交给模型,让它组织答案。资料更新了,只要把新资料整理进检索库,第二天就能查到,通常不用重新训练模型。它的成本主要是整理资料、建立索引,以及每次有人提问时检索、排序和生成答案的费用。
从微调模型的方式来说,更像是给这个学生做专项培训:要求他按固定格式答题,学会档案领域的术语,或者把分类、抽取这类任务做得更稳定。培训可以改变他的答题习惯,但不适合拿来保存每天都在变化的档案原文。材料写进模型参数后,想像删除一条索引那样证明它已经彻底忘记,实际上很难;让它准确说出原件页码和当前开放状态,也不是微调天然能做到的。所以,微调可以帮助模型做事,但不能代替受控检索。
继续预训练更像是让学生重新读大量专业教材,花的时间和机器都更多,目的是让他更熟悉某个领域的说法。自己从零训练基础模型,则相当于从小学阶段开始培养一名学生,除了大量语料和 GPU,还要处理数据清洗、训练是否稳定、能力有没有退步等问题。绝大多数档案项目没必要走到这一步。更实际的做法是选一个能在本地部署的基础模型,用少量高质量样本把任务教清楚,再用 RAG 去提供会变化、需要引用和受权限控制的事实。
账也可以这样算。假设每天有 2000 次问答,每次给模型 4000 个上下文 token,再让它生成 600 个 token,一天大约就是 920 万 token 的推理量。把上下文缩短一点、减少无关候选、提高缓存命中率,都会影响每天的持续成本。微调则要另外付训练样本、训练轮次、序列长度和 GPU 时间的费用。训练做完以后,前面那 920 万 token 的日常查询并不会凭空消失。至于从头训练,花费更是另一种量级,不能和普通 RAG 查询混在一起比较。
三种做法也要用不同方式检查。RAG 要看能不能找到正确材料、引用是不是回到原文、权限有没有挡在前面;微调要看格式是否稳定、任务成功率有没有提高、换一批没见过的材料还能不能做对;继续训练则要看专业能力提高后,通用能力有没有明显下降。假如有人说“训练一次以后就不用 RAG 了”,可以让他现场完成三件事:新放进去的材料马上能查,撤销权限后原来的人马上查不到,答案还能回到准确页码。只靠模型参数,通常很难同时满足这三个条件。
所以,权限前置并不一定和省钱冲突。先把无权资料挡在检索之前,后面的排序和模型上下文就少处理一些内容,token 反而可能下降。关键是把权限字段、索引和缓存一起设计好,而不是把安全和成本简单地摆成对立面。
举个普通人更容易理解的例子:公司把工资表放进了内部问答系统。财务经理可以问“八月份工资总额是多少”,普通员工只能查自己的工资。如果系统先把整张工资表交给模型,最后只在页面上显示一行“你没有权限查看”,页面看上去没泄露,但模型和缓存已经接触过全表。正确做法是,用户提问时就先确定身份和范围,普通员工的查询只能进入自己的工资记录。
页面没显示,不代表系统没看见
普通人可以把它想成去档案室查一份材料。工作人员先确认你是谁,再去库房找一批可能相关的盒子,接着从里面挑出最符合问题的几份,最后把结果写在纸上交给你。页面上只有最后那张纸,但前面的人、库房和登记台都已经接触过这次查询。
RAG 也是这样。一次查询背后会经过身份确认、候选检索、重新排序、拼接上下文、模型回答、结果过滤和缓存。每一步都有可能复制、加工或暂时保存片段。
假设系统先找出 50 个片段,排序模块看完后留下 10 个,大模型从中引用 3 个,页面最后只显示 1 个。用户没有看到另外 49 个,并不能说明另外 49 个从未被系统处理。只要权限检查放在最后,排序模块可能已经看过它们,大模型可能已经收到了其中 10 个,缓存也可能留下了候选编号或答案。
这就像快递员把不该送给你的文件收回去,不能因为你最后没拿到文件,就说文件从未离开过仓库。要判断安全不安全,得查每个环节的记录,而不是只看最后一页。
这也解释了为什么“模型没有在答案里泄露敏感内容”仍然不够。模型这一次没说,不代表下一次改写问题、延续会话或命中缓存时也不说;更不能证明敏感原文此前没有被发送给某个组件。访问控制要求系统从数据路径上阻止越权接触,不能把希望寄托在模型保持克制上。
比较稳妥的做法,是查询一开始就确定用户、岗位、部门、授权范围和有效期,再把这些条件带给全文检索、向量检索或数据库。只有通过这一步的片段,才可以继续交给排序和模型。答案返回前再查一次资源状态,是为了防止查询过程中刚好发生撤权;它是最后一道保险,不能代替前面的检查。
“内网部署”没有结束这个问题
档案行业处理受控数据时,应优先采用本地、内网或专有环境部署,原文、向量、检索日志和模型上下文不应发送给未经批准的在线公共模型。这个边界必须明确。
但服务器搬进机房以后,内部权限仍然存在。业务系统、向量库、全文索引、排序服务、模型服务、缓存和日志平台,通常不是同一个程序,也不一定使用同一个账号。普通利用者无权看的材料,不能因为模型在内网,就默认交给所有组件。内网主要解决“数据会不会传到外面”,内部权限解决“数据在机房里会经过谁”。
比如一家单位把离职人员的合同放在内网,离职当天业务系统已经收回账号,但向量库里的旧片段和缓存没有更新。这个人再次提问时,页面也许提示无权限,系统内部却可能先命中旧缓存。问题不在模型是否在线,而在权限变更有没有传到索引和缓存。
不少系统会在这里留下空档:业务库里有开放状态和部门权限,向量库里却只有 chunk_id、文本和 embedding。检索时没有条件可用,只能先全库召回,再回业务库逐条判断。演示页面可能没有问题,但敏感片段已经交给了不该先看到它的中间组件。
补这个缺口通常不需要换更大的模型,甚至和模型大小没有关系。需要补的是资源标识、权限字段、权限变化到索引的同步,以及权限服务出故障时怎么处理。高风险场景下,权限服务超时就拒绝查询,或者只查公开资料,不能为了让页面继续工作而悄悄取消过滤。
缓存最容易把一次合法访问变成下一次越权
讨论检索权限时,大家很容易只盯着向量库,忘了缓存。系统可能缓存查询结果、排序结果、上下文片段或最终答案。如果缓存只按问题文字做键,高权限用户先问过的问题,低权限用户可能直接拿到同一份结果,后面甚至不会重新检查权限。
缓存不能只绑定用户 ID。一个人的岗位会变,专项授权会到期,档案也可能从未开放变成开放,或者反过来。缓存至少要知道这次查询对应的权限范围、规则版本、索引版本和问题摘要;权限变化后,旧的候选结果、上下文和答案都要失效。
这不是故意找极端情况。缓存本来就是为了少算一遍,而权限检查可能正好在被跳过的那一段里。系统越想省时间和机器,就越要确认优化没有绕开权限。把权限放进缓存设计,通常比出了问题以后清理泄露范围便宜得多。
别争“安全不安全”,实际测一次
“安全”“成本高”“没必要”这些话,单靠争论很难说清。拿测试账号做一次撤权试验,通常一个下午就能发现问题。
先准备两个测试账号。账号 A 可以访问受控文件 DOC-SEC-017,账号 B 不可以。准备一个能查到这份文件的问题,再准备一句意思相同但说法不同的问题。开始前记下权限规则版本、索引版本和缓存状态。
先让 A 正常查一次,让系统产生检索结果、模型上下文和缓存。然后收回 A 对这份文件的权限,等权限变化同步完成,再让 A 查原问题、改写问题,并在原会话里追问一次。最后让 B 查同一个问题,看 A 留下的缓存会不会影响 B。
日志不必保存敏感正文,但要能看出每个环节处理过哪些文件:
request_id: req-20260819-0042
actor_id: user-a
policy_version: pv-2026.08.19-7
index_version: idx-2026.08.19-2
permission_scope_hash: 4b7c...
retrieval_doc_ids: [DOC-OPEN-003, DOC-OPEN-019]
reranker_input_doc_ids: [DOC-OPEN-003, DOC-OPEN-019]
context_doc_ids: [DOC-OPEN-003]
cache_namespace: pv-2026.08.19-7:idx-2026.08.19-2
answer_citation_doc_ids: [DOC-OPEN-003]撤权后,DOC-SEC-017 应该同时从检索结果、排序输入、模型上下文、缓存和答案引用里消失。如果它只是在最终答案里消失,说明系统只是把页面擦干净了,前面的环节仍然看过。如果原问题查不到,换一种说法却能查到,说明某条查询路径漏了过滤。如果新会话安全,旧会话还能复述,说明会话记录也没有跟着撤权。
还可以暂时停掉权限服务,看看系统怎么处理。返回明确错误,或者只允许查公开资料,是比较容易接受的结果;权限服务超时后仍然从全库召回,就说明系统在故障时反而放宽了权限。这个结果和模型是 7B、32B 还是 70B 没有直接关系。
如果要反对,应该反对哪一部分
原文章当然可以被质疑。比如有人可以提出另一种做法:先由业务库找出用户有权看的文件编号,再让向量库只在这批文件里检索;也可以拿测试数据证明,某类公开资料用独立索引更简单,不需要做复杂的个人权限控制。
这样的反对意见要把几件事说清楚:要保护的是什么数据,防谁,系统部署在哪里,片段会经过哪些模块,权限到底在哪一步检查。如果觉得前置过滤太贵,就把候选数量、过滤耗时、并发量、缓存命中率和压测结果拿出来,再说明自己的方案怎样保证排序模块和模型不会看到无权内容。
这种讨论可能证明原来的设计确实太重,也可能发现权限字段没设计好,最后还可能形成“公开资料分一个库、受控资料再做细过滤”的组合方案。大家讨论的是证据、范围和代价,别人可以照着重新测试。
但如果文章问的是“敏感片段经过了哪些模块”,回答始终停在“模型值不值得买”,那就还没有回答原来的问题。读者既不知道哪里可能越权,也不知道成本到底增加了多少。
放回档案场景看
档案场景更容易遇到这种问题。一份目录可以公开,原文却还没有开放;同一份材料,岗位变了、期限到了、开放鉴定结果变了,能不能查也会跟着变。模型可以帮忙找线索,但不能靠相似度分数决定谁能利用原文。
领至科技做档案 AI 项目时,会把业务权限、索引字段、检索、排序、缓存和模型上下文放在同一条链路里检查。判断项目是否可靠,不能只看一句“系统安全”,还要看撤权以后能不能拿出同一个请求在各环节处理过的文件编号,能不能解释某个片段为什么被放行或拦住,索引重建、模型升级和权限变化以后,能不能重新测出同样的结果。
这场留言讨论至少提醒了我们一件事:读一篇技术文章,先看它究竟在问什么,再决定赞成还是反对。模型好不好,可以测;每天要花多少钱,可以算;敏感片段有没有越过权限边界,可以沿着日志和文件编号去核对。三件事分开说,读者才知道系统到底哪里值得改,钱又该花在哪里。